ETL và ELT là gì? Khác biệt và lý do giữ raw data
ETL và ELT là gì, khi nào dùng mỗi cách? Tìm hiểu qua Undercroft vì sao giữ raw data trước giúp build lại model khi quy tắc nghiệp vụ thay đổi.
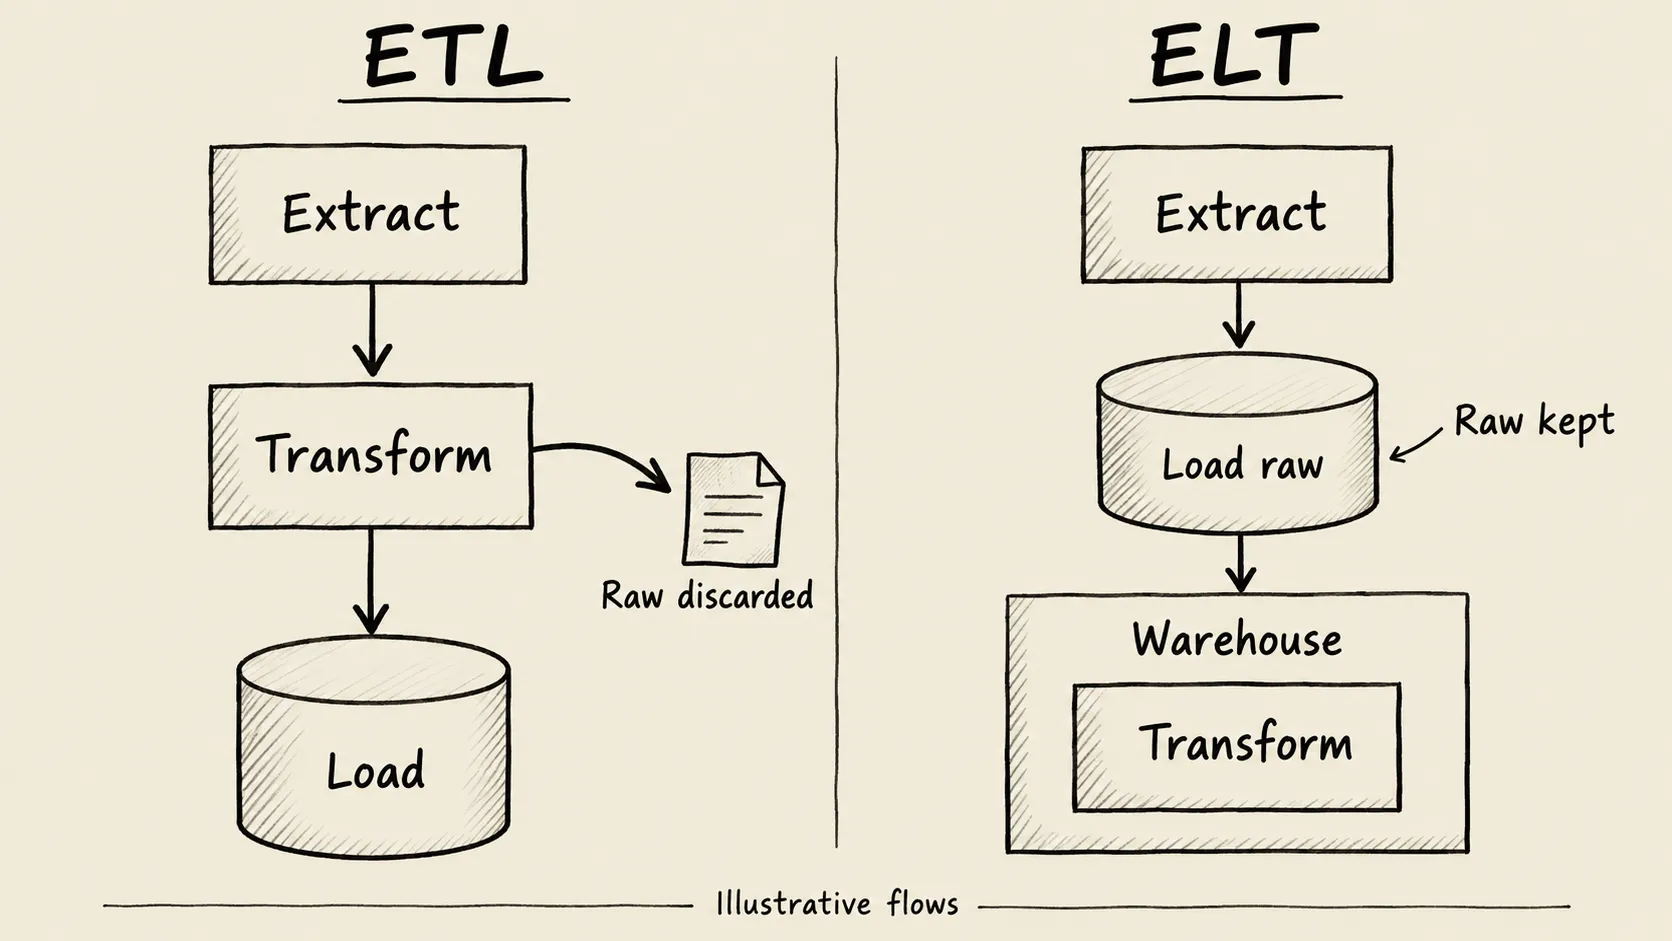
ETL và ELT là gì, và khác biệt đó ảnh hưởng thế nào khi sửa một report? ETL thực hiện transform trước khi load vào nơi phục vụ phân tích. ELT load trước rồi mới transform. Với đội tài chính và vận hành, câu hỏi thực tế là: khi đổi cách tính một chỉ tiêu, dữ liệu ban đầu còn đủ để tính lại không?
Undercroft là ví dụ cho cách giữ raw data trước: REST API → raw data lake trên S3 hoặc MinIO → Postgres → dbt model → BI. Mỗi lớp có một nhiệm vụ riêng, để việc sửa quy tắc nghiệp vụ không buộc connector phải đổi theo.
ETL là gì và một ETL pipeline hoạt động ra sao?
ETL viết tắt của extract, transform, load. Bước extract đọc dữ liệu từ nguồn. Bước transform chọn trường, chuẩn hóa hoặc tổng hợp. Bước load đưa kết quả vào nơi phục vụ phân tích, chẳng hạn data warehouse.
Ví dụ, một ETL pipeline đọc đơn hàng, phân nhóm theo tháng rồi chỉ lưu số đơn của từng tháng. Đội vận hành có ngay dữ liệu đúng cấu trúc để làm dashboard, không cần xử lý từng đơn khi mở report.
Đổi lại, nếu sau đó cần đếm theo ngày, số tổng theo tháng không đủ. Đội kỹ thuật phải tìm dữ liệu chi tiết đã lưu ở chỗ khác hoặc đọc lại nguồn. Nguồn có thể đã sửa hoặc xóa dữ liệu cũ.
ETL không bắt buộc phải bỏ raw data. Hình đầu bài minh họa trường hợp ETL chỉ giữ kết quả đã transform. Một ETL pipeline có raw data archive riêng vẫn có thể tính lại; khả năng đó đến từ việc giữ đầu vào.
ELT là gì và khác ETL ở bước nào?
ELT viết tắt của extract, load, transform. Dữ liệu được load vào môi trường phân tích trước, rồi SQL hoặc công cụ như dbt mới áp dụng quy tắc nghiệp vụ.
Connector lo cách đọc nguồn; model lo định nghĩa chỉ tiêu. Nếu cùng một tập đơn hàng phục vụ cả tài chính và vận hành, mỗi đội có thể dùng model riêng với cách chọn ngày và trạng thái được viết rõ trong SQL.
Load trước không có nghĩa là bỏ kiểm tra. Data pipeline vẫn cần xác định record, xử lý lỗi đọc và kiểm soát quyền truy cập. Raw data cũng chưa phải dữ liệu sẵn sàng cho dashboard: model vẫn phải quy định kiểu dữ liệu, quan hệ và cách xử lý giá trị thiếu.
ETL và ELT là gì, khác nhau ở điểm nào?
Điểm chính là vị trí của transform so với bước load vào nơi phục vụ phân tích. Không thể chỉ nhìn ba chữ cái để kết luận cách nào nhanh hoặc rẻ hơn.
| Câu hỏi | ETL | ELT |
|---|---|---|
| Áp dụng quy tắc nghiệp vụ lúc nào? | Trước khi load | Sau khi load |
| Dữ liệu đi vào trước có dạng gì? | Đã được xử lý | Còn gần với cấu trúc nguồn |
| Sửa cách tính ở đâu? | Bước transform phía trước | Model phía sau |
| Muốn tính lại cần gì? | Đầu vào đã giữ hoặc đọc lại nguồn | Đầu vào đã load và còn đủ chi tiết |
| Đội phụ trách phải quản lý gì? | Transform và cấu trúc đầu ra | Raw data, quyền đọc và model |
Chi phí thực tế còn phụ thuộc lượng dữ liệu, SQL và hạ tầng. Khi đánh giá, hãy yêu cầu một ví dụ đổi quy tắc rồi xem cần sửa những đâu, dữ liệu nào còn giữ và dữ liệu nào phải lấy lại.
Khi nào nên dùng ETL, khi nào nên dùng ELT?
ETL phù hợp khi nơi nhận chỉ nên chứa một tập trường đã chọn, khi cần xử lý trước ranh giới đó, hoặc khi hệ thống phía sau đòi hỏi schema ổn định. Nếu cần phân tích lại về sau, hãy quyết định riêng việc giữ raw data.
ELT phù hợp khi nhiều đội dùng chung nguồn nhưng có cách nhìn khác nhau, hoặc định nghĩa chỉ tiêu thường thay đổi. Đội quen SQL có thể quản lý logic trong model thay vì đưa mọi yêu cầu vào connector.
Chẳng hạn, vận hành đếm đơn hoàn tất còn tài chính cần phân nhóm theo một ngày nghiệp vụ khác. Nếu các trường liên quan còn nguyên, có thể viết hai model. Nếu chỉ giữ một số tổng, yêu cầu thứ hai có thể buộc phải đọc lại nguồn.
Trong một hệ thống cũng có thể có cả hai cách. Điều cần thống nhất là dữ liệu nào phải giữ, ai sở hữu quy tắc và cách áp dụng quy tắc mới cho dữ liệu cũ.
Undercroft tổ chức ELT pipeline như thế nào?
Undercroft là data platform open-source, hiện ở giai đoạn pre-alpha. Kiến trúc đặt raw data lake bất biến dưới các lớp dùng để truy vấn.
Luồng record gồm năm bước:
- Đọc REST API bằng connector. YAML mô tả cách đọc nguồn; Xero và HubSpot là các ví dụ có trong repository. Bài data integration với REST API và YAML connector giải thích phần này.
- Ghi vào S3 hoặc MinIO. Lake chỉ tạo mới, không ghi đè object đã có. Nội dung giống nhau không cần thêm một blob khác.
- Đưa vào Postgres. Record từ các nguồn dùng chung bảng
raw.records, phần nội dung làjsonb. Đây là lớp biểu diễn dữ liệu đã giữ trong lake để phục vụ truy vấn. - Build dbt model. Worker gọi
dbt builddưới dạng subprocess. Người dùng viết SQL định nghĩa các bảng phân tích của mình. - Đọc model qua BI. Reports có question và dashboard. BI login của từng tenant đọc model phân tích của tenant đó, không đọc trực tiếp schema
raw.
Undercroft không cung cấp business schema mặc định cho khách hàng hay hóa đơn. Nhờ vậy, nền tảng không áp một định nghĩa chung lên mọi doanh nghiệp; người viết model cũng phải tự chịu trách nhiệm về quy tắc và kiểm tra dữ liệu.
Bài raw data lake bất biến giải thích kỹ hơn lý do giữ lớp này. Postgres phục vụ truy vấn, còn lake giữ đầu vào để có thể dựng lại các lớp dữ liệu phía trên.
Đổi quy tắc nghiệp vụ thì build lại model ra sao?
Giả sử công ty minh họa Acme định nghĩa khách hàng hoạt động là có đơn trong 30 ngày gần nhất. Đội vận hành đổi khoảng thời gian thành 90 ngày. Đây là ví dụ do người dùng tự định nghĩa, không phải model có sẵn của Undercroft.
Nếu chỉ lưu cờ đúng hoặc sai theo quy tắc cũ, không thể suy ra ngày đặt đơn gần nhất. Nếu đã giữ ngày và mã liên quan, model có thể tính lại với điều kiện mới.
Đoạn SQL dưới đây chỉ minh họa thay đổi điều kiện. customer_activity và các cột là model giả định mà đội phải tự xây dựng, không phải bảng Undercroft cung cấp.
-- Illustrative: replace the previous 30-day condition.
select customer_id,
       last_order_date >= date '2026-09-29' - interval '90 days'
         as is_active
from customer_activity;
Ngày đánh giá được cố định để dễ đối chiếu. Nếu thiếu last_order_date, phép so sánh cho kết quả chưa biết, không tự suy đoán khách hàng có hoạt động.
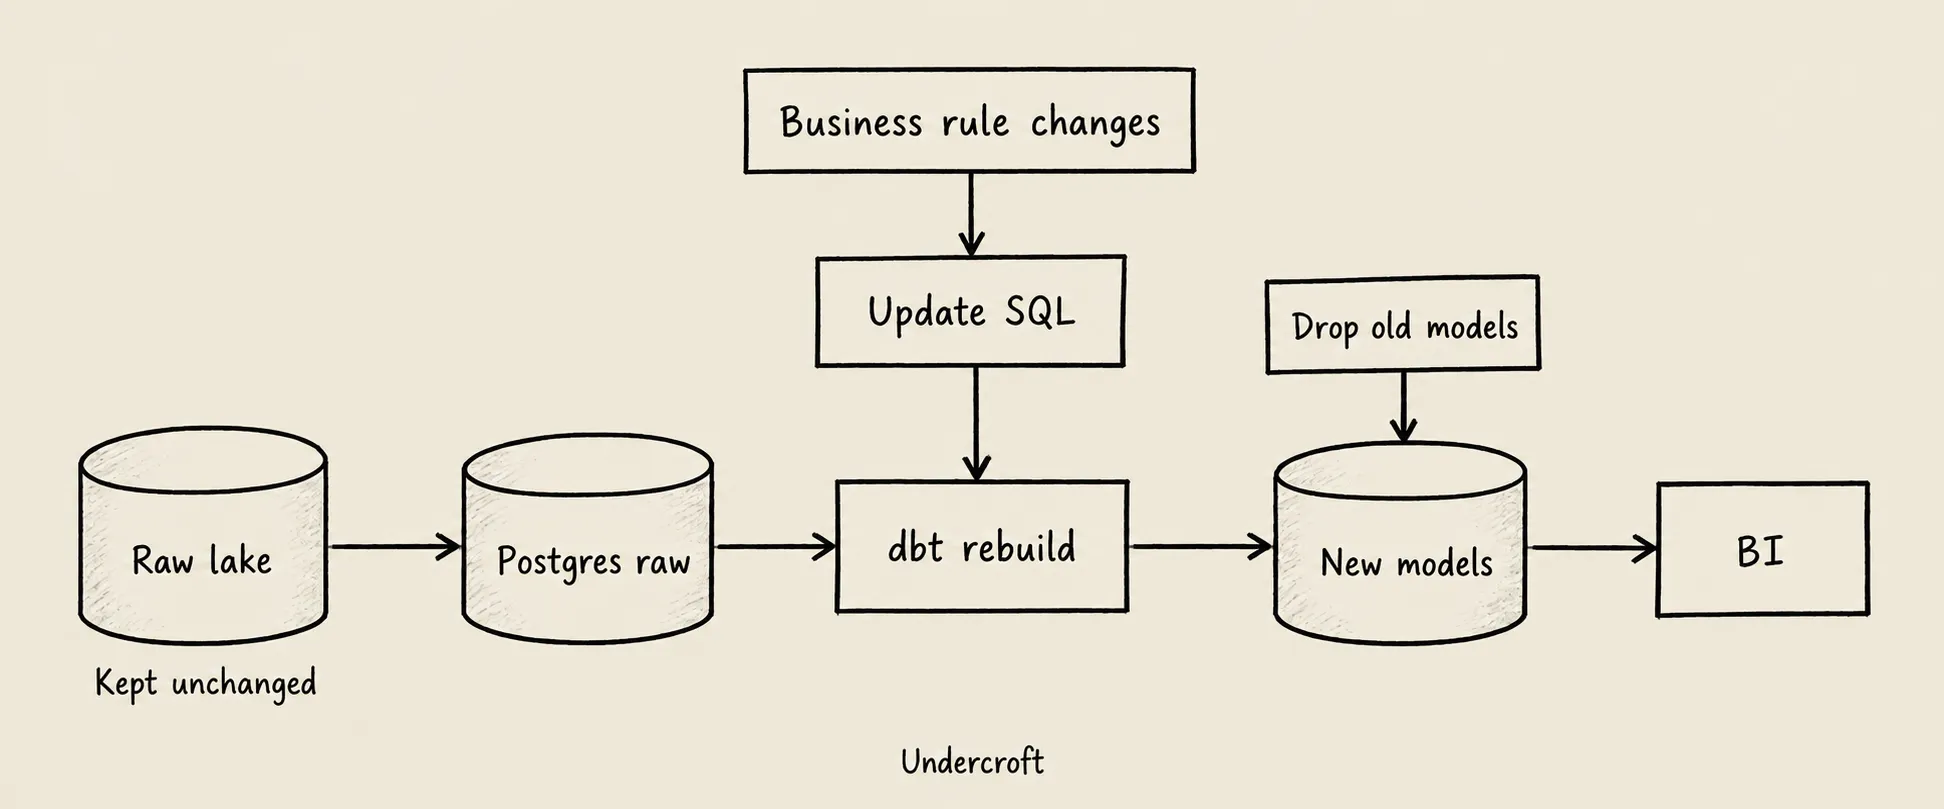
Trong kiến trúc Undercroft, có thể drop và build lại dữ liệu dẫn xuất mà vẫn giữ lake. Khi chỉ sửa model, có thể dùng lớp dữ liệu hiện có trong Postgres; không cần dựng lại mọi bảng. Sơ đồ thể hiện quan hệ phụ thuộc, không phải thao tác bắt buộc cho mỗi lần sửa.
Đội phụ trách cần giữ định nghĩa model, kiểm tra đủ đầu vào, sửa SQL rồi build và đối chiếu kết quả cùng các model phụ thuộc. Build thành công chưa chứng minh quy tắc mới đúng với nghiệp vụ.
Giữ raw data có bảo đảm khôi phục mọi lịch sử không?
Không. Lake chỉ giữ những gì đã đọc được. Trường chưa lấy, record bị xóa trước lần sync hoặc phiên bản trung gian chưa quan sát được không thể xuất hiện nhờ sửa SQL.
raw.records biểu diễn lần quan sát mới nhất của mỗi record. Có phiên bản trong lake không đồng nghĩa mọi model đã có sẵn góc nhìn lịch sử; vẫn cần đầu vào phù hợp và logic sử dụng chúng.
Khả năng build lại còn phụ thuộc dữ liệu giữ lại và định nghĩa model. Vì vậy, “build lại mọi model” là nguyên tắc tổ chức dữ liệu dẫn xuất, không phải lời hứa giữ lịch sử vô hạn hay tự khôi phục quy tắc chưa được ghi lại.
Câu hỏi thường gặp
ELT có luôn tốt hơn ETL không?
Không; ETL phù hợp khi cần transform trước nơi nhận, còn ELT thuận tiện cho model dựa trên đầu vào đã load. Nên chọn theo ranh giới dữ liệu và cách đội quản lý thay đổi.
ETL có bắt buộc bỏ raw data không?
Không; ETL có thể giữ raw data archive riêng. Khả năng tính lại phụ thuộc vào đầu vào còn giữ, không chỉ thứ tự ETL hay ELT.
dbt có thay connector trong data pipeline không?
Trong Undercroft, dbt đảm nhiệm transform sau khi dữ liệu đã vào lake và Postgres. Connector đọc nguồn, nên hai phần có nhiệm vụ khác nhau.
Build lại model có cần gọi REST API lần nữa không?
Không cần nếu đầu vào cần thiết đã được giữ và có thể dùng để dựng lại model. Nếu quy tắc mới cần trường chưa từng lấy, phải đọc thêm nguồn và có thể nguồn không còn dữ liệu đó.