Data integration là gì? Tích hợp REST API bằng YAML
Data integration là gì? Tìm hiểu cách tích hợp dữ liệu từ REST API bằng YAML connector, quản lý auth, pagination, watermark và lỗi khi sync.
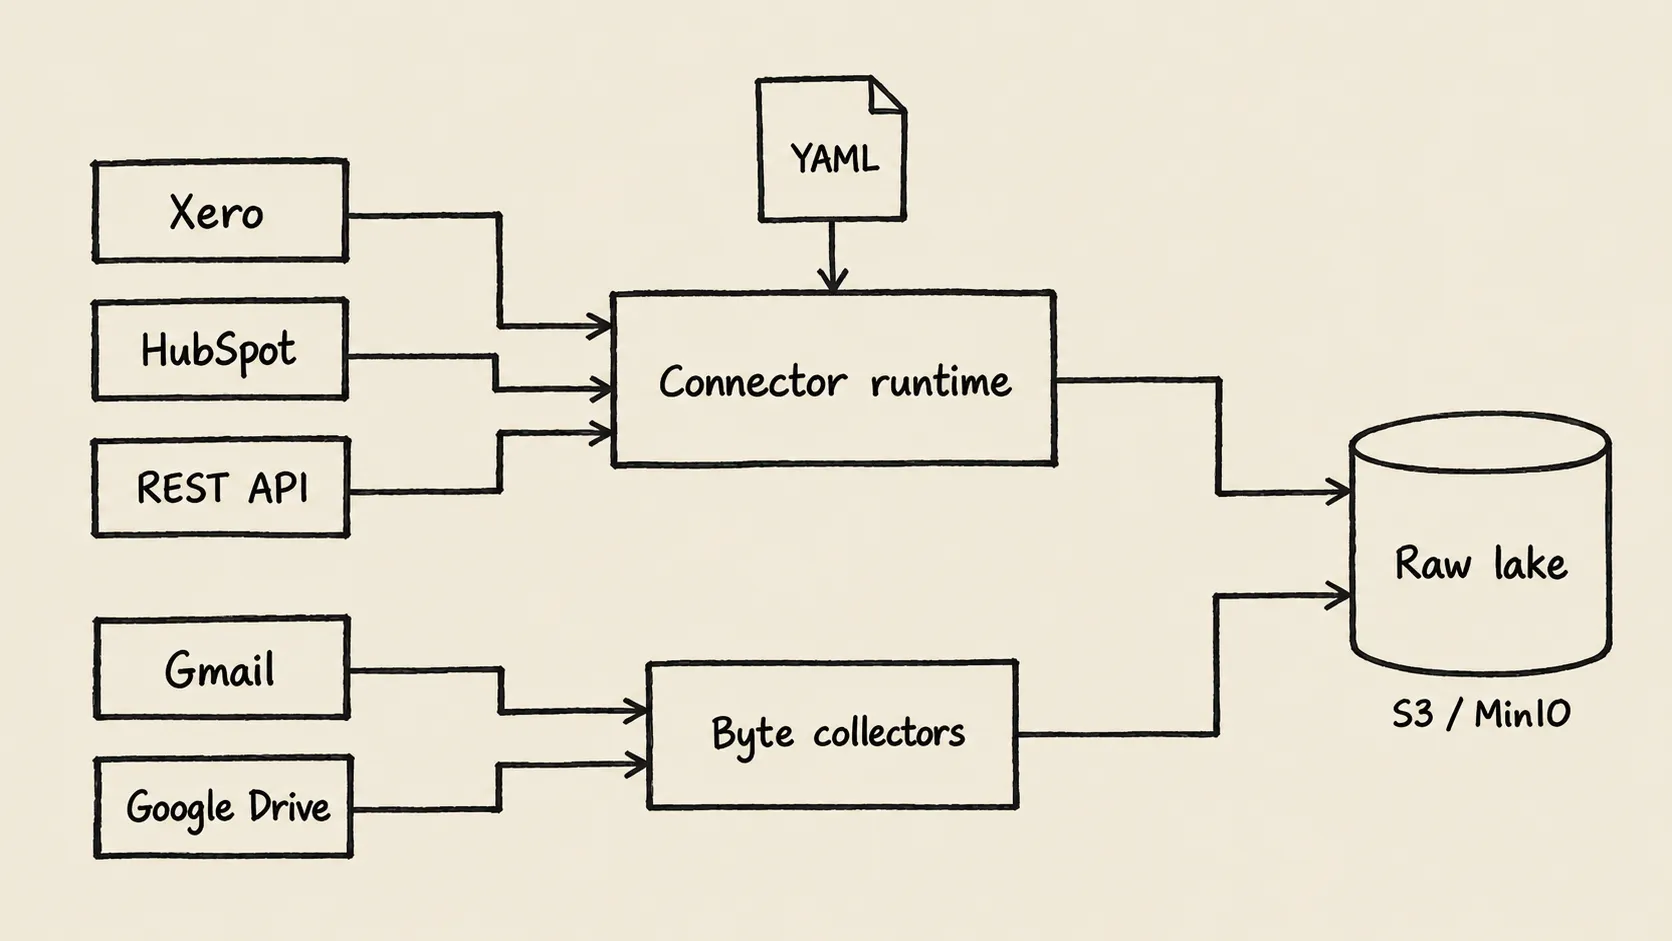
Data integration là gì khi áp dụng vào công việc hằng ngày? Đó là việc đưa dữ liệu từ các hệ thống riêng lẻ về một cách sử dụng chung. Chẳng hạn, đội finance cần đối chiếu hóa đơn trong Xero với thông tin bán hàng ở HubSpot và tài liệu nhận qua Gmail. Lấy được dữ liệu chỉ là bước đầu; còn phải biết đã đọc đủ chưa, lần cập nhật nào được giữ lại và số liệu trong report được tính theo quy tắc nào.
Với REST API, nhiều phần của công việc này có thể mô tả bằng YAML connector. Undercroft dùng một runtime chung để thực hiện các khai báo đó, lưu raw data trước rồi mới để người dùng viết dbt model cho nhu cầu riêng.
Data integration là gì, khác data pipeline ở đâu?
Data integration là mục tiêu làm cho dữ liệu từ nhiều nguồn có thể dùng cùng nhau. Data pipeline là chuỗi bước đọc, lưu và xử lý dữ liệu. API connector phụ trách giao tiếp với một nguồn: auth, endpoint, pagination và cách nhận biết thay đổi.
Trong Undercroft, record từ REST API đi vào raw data lake trên S3 hoặc MinIO, rồi được đưa vào bảng chung raw.records trong Postgres. Người dùng viết SQL qua dbt model để tạo các bảng phục vụ BI. Platform không định nghĩa sẵn thế nào là khách hàng hay doanh thu của doanh nghiệp.
Cách tổ chức này giúp đội kỹ thuật sửa model mà vẫn có raw data đã lưu để xử lý lại. Bài về raw data lake bất biến giải thích lớp lưu trữ này; bài ETL và ELT làm rõ vị trí của bước biến đổi dữ liệu.
YAML connector thay thế phần code nào?
Một declarative connector mô tả yêu cầu đọc dữ liệu thay vì viết lại vòng lặp HTTP cho từng nguồn. Undercroft kiểm tra spec theo schema; repo hiện có YAML connector cho Xero và HubSpot.
| Thành phần | Khai báo trong spec | Câu hỏi cần trả lời |
|---|---|---|
| Auth | Bearer token hoặc OAuth | Đọc bằng quyền của connection nào? |
| Endpoint | URL, path, query | Cần lấy danh sách và trường nào? |
| Identity | envelopePath, idPath |
Record nằm ở đâu, ID là gì? |
| Pagination | Page number, cursor, next link, offset hoặc none | Làm sao đọc hết danh sách? |
| Incremental sync | Strategy, source field, format | Lần sau dùng watermark thế nào? |
| Reliability | Rate limit, retry, guard | Khi bị giới hạn hoặc lỗi thì xử lý ra sao? |
Nguồn phù hợp với schema có thể khai báo cách đọc bằng YAML mà không cần database migration. Tuy nhiên, đưa nguồn mới lên giao diện vẫn cần đóng gói spec vào worker, đăng ký nguồn ở control plane và release. Đây không phải tính năng tải YAML bất kỳ lên là có ngay màn hình connection.
Repo Undercroft chứa spec và schema để kiểm tra; dự án open-source theo MIT và đang ở giai đoạn pre-alpha.
Auth và pagination được khai báo ra sao?
HubSpot dùng bearer token lấy từ connection. Xero dùng OAuth với refresh-token rotation và header chứa ID organisation bên Xero. Secret không được viết trực tiếp vào YAML công khai.
Pagination phải theo từng endpoint. Mặc định Xero bắt đầu từ page=1, đọc đến khi gặp trang rỗng. Endpoint trả toàn bộ danh sách một lần dùng kind: none. HubSpot dùng next link hoặc cursor after tùy entity.
Đây là phần invoices thật trong specs/connectors/xero.yaml. Đoạn trích kế thừa auth, pagination, pacing và retry từ spec đầy đủ; riêng nó chưa phải một connector hoàn chỉnh.
- name: invoices
  request: { kind: list, path: /Invoices, query: { pageSize: "500", unitdp: "4" } }
  readScope: accounting.invoices.read
  envelopePath: Invoices
  idPath: InvoiceID
  updatedAtPath: UpdatedDateUTC
  incremental:
    strategy: header
    header: If-Modified-Since
    sourcePath: UpdatedDateUTC
    format: ms-json-date
    send: rfc3339-seconds
envelopePath chỉ đến danh sách invoices, còn idPath xác định ID từng record. Thiếu ID sẽ phát sinh lỗi, không tự đoán khóa để lưu. Query unitdp yêu cầu Xero trả đơn giá với bốn chữ số thập phân.

Incremental sync dùng watermark thế nào để tránh bỏ sót?
Watermark ghi nhận mốc nguồn đã được đọc thành công. Undercroft lưu mốc này riêng với cursor đưa dữ liệu từ data lake vào Postgres, vì hai bước hoàn thành ở những thời điểm khác nhau.
Watermark chỉ tiến sau khi đọc xong entity. Nếu lỗi ở giữa danh sách, lần sau vẫn dùng mốc trước đó. Lấy timestamp lớn nhất trong phần đã lưu có thể bỏ qua record cũ hơn nằm ở trang chưa đọc.
Giá trị watermark được giữ cùng format của nguồn. Với Xero, runtime lưu Microsoft JSON date nhưng gửi header theo RFC 3339 UTC, làm tròn xuống giây. Đây là hai cách biểu diễn mà phía trả dữ liệu và phía nhận filter yêu cầu.
Watermark còn gắn với request. Khi query hoặc tập properties thay đổi, mốc cũ có thể không còn hợp lệ; danh sách cần được đọc toàn bộ theo request mới, trong giới hạn budget.
Schema có ba strategy: header, query-param và client-filter. HubSpot dùng client-filter: vẫn đọc mọi trang, chỉ bỏ qua bước lưu record cũ hơn watermark. Cách này giảm công việc phía sau, không giảm số API request.
Với Xero, change filter không thấy mọi chỉnh sửa. Connection có thể bật lịch re-sync để đọc toàn bộ lại trong các lần sync. Re-sync mặc định là paused; nếu không bật, những chỉnh sửa filter không thấy có thể vẫn giữ giá trị cũ.
Rate limit và lỗi sync có bị biến thành dữ liệu rỗng không?
Không. Lỗi connector phát sinh ConnectorError, kèm số record đã thấy. Thông tin đó giúp phân biệt lỗi xảy ra ngay đầu lần đọc với lỗi sau khi đã nhận một phần dữ liệu, nhưng vẫn cần xem nguyên nhân cụ thể.
Cả hai spec đều cấu hình retry cho 429, 500, 502, 503, 504 và tôn trọng Retry-After. Xero đặt khoảng cách request tối thiểu 1.100 milliseconds, đồng thời giới hạn thời gian chờ từ header này.
Spec Xero hiện đặt 1.000 request mỗi ngày, trong đó whole read được dùng 800, giữ lại 200 làm reserve. Worker dùng header báo budget còn lại từ Xero khi có. Khi budget hết, whole read có thể dừng với cảnh báo trong journal; phần đọc chưa hoàn tất không lưu watermark mới. Lần đọc toàn bộ sau bắt đầu lại từ đầu.
Danh sách rỗng hợp lệ là chuyện khác. Spec cho phép một số entity không có record; incremental read thực sự gửi watermark cũng có thể không thấy thay đổi. Danh sách thiếu quyền được ghi rõ là chưa được cấp quyền. Không nên diễn giải các trường hợp này thành “doanh nghiệp không có dữ liệu”.
Đặt lịch sync và kiểm tra kết quả ở đâu?
Connection hỗ trợ lịch mỗi giờ, mỗi sáu giờ, hằng ngày, paused hoặc cron năm trường. Cron dùng múi giờ Asia/Singapore, không phải giờ Việt Nam. Scheduler kiểm tra mỗi năm phút và từ chối biểu thức có các lần chạy sát nhau hơn khoảng đó.
Khi kiểm tra, đọc cả counts lẫn run journal. Undercroft lưu event có cấu trúc trong ops.run_event, nên đóng trình duyệt không làm mất bằng chứng của run. Event dùng loại sự kiện, counts và ID; giao diện hiển thị nội dung theo ngôn ngữ người đọc.
Một run có trạng thái thành công vẫn có thể chứa cảnh báo budget hoặc danh sách chưa được cấp quyền. Trước khi dùng cho report, nên xem lần đọc toàn bộ đầu tiên, một lần incremental sync và phạm vi dữ liệu model thực sự nhận được.
Nên đọc hướng dẫn nào cho Xero, HubSpot, Gmail và Drive?
Mỗi nguồn có đặc điểm riêng cần kiểm tra trước khi ghép vào data pipeline:
- Tích hợp Xero vào Postgres cho dữ liệu kế toán trong ví dụ YAML.
- Tích hợp HubSpot vào Postgres cho CRM object và quan hệ.
- Tích hợp Gmail đưa email vào database cho luồng email.
- Tích hợp Google Drive với OCR cho tài liệu.
Gmail và Google Drive dùng collector viết bằng code vì có nội dung dạng bytes mà JSON connector runtime không biểu diễn. Chúng dùng chung pacing, retry và đường ghi data lake. Nguồn nằm ngoài khả năng của YAML có thể dùng external caller qua REST lake API; không cần ép mọi kiểu dữ liệu vào spec.
Câu hỏi thường gặp
Data integration có phải là ETL không?
ETL là một cách tổ chức các bước trong quá trình tích hợp dữ liệu. Undercroft lưu raw data trước rồi chạy dbt model do người dùng viết, theo cách tiếp cận ELT.
API connector bằng YAML có cần viết code không?
Với REST API phù hợp schema, cách đọc được khai báo trong YAML thay cho vòng lặp request riêng. Đưa nguồn vào sản phẩm vẫn cần đăng ký và release; trường hợp ngoài schema cần đường ingest khác.
Incremental sync có luôn tiết kiệm API request không?
Không, client-filter vẫn đọc mọi trang. Chỉ filter phía nguồn qua header hoặc query mới có thể giảm dữ liệu trả về theo khả năng của endpoint.
Sync thành công có nghĩa là dữ liệu đã đầy đủ không?
Chưa đủ để kết luận: cần xem journal, phạm vi quyền và budget. Với nguồn có change filter không thấy mọi chỉnh sửa, còn phải kiểm tra lịch re-sync.